Technomedia

Numérique · médias · sciences · intelligence artificielle

Journée mondiale de la santé : les nouvelles technologies, source de nouveaux défis à court terme

esanté


Analyse de Scott Lundstrom, Senior Industry Strategist for Healthcare chez OpenText

« À l'occasion du 75e anniversaire de la Journée mondiale de la santé, le thème est "la santé pour tous". La dernière décennie a été une période de transformation pour les soins de santé, non seulement pour la R&D, mais aussi pour acheminer des solutions technologiques pour favoriser l'accès aux soins des patients.

Il s'agit là d'une excellente nouvelle pour les patients : les professionnels de santé disposent des capacités nécessaires pour fournir les meilleurs soins possibles. Pourtant, la réalité de l'introduction de nouveaux outils n'est pas aussi simple. La mise en œuvre de nouvelles technologies continue de poser toute une série de challenges au secteur.

Les piles technologiques des organisations peinent à trouver leur équilibre, chaque élément s'efforçant de rester en harmonie avec les autres. Face à des problèmes tels que ceux rencontrés lors de la pandémie, les organisations sont souvent contraintes d'adopter rapidement de nouvelles solutions. Chaque nouvelle technologie complique davantage la vision qu'a une organisation de ses opérations et la mise en œuvre de technologies modernes présente fréquemment de nouveaux défis à court terme. Ce n'est pas un secret, la gestion des milliers d'appareils médicaux qui dispensent quotidiennement des soins est une tâche difficile.

Internet des objets médicaux

La bonne nouvelle est que l'adoption de la technologie IoT au sein des dispositifs médicaux, et plus particulièrement de l'Internet des objets médicaux (IoMT), allège considérablement la pression qui pèse sur les prestataires de soins de santé. Le marché de l'IoMT, qui devrait atteindre 176 millions de dollars d'ici à 2026, est l'un des secteurs de l'IoT qui connaît la croissance la plus rapide. Il tente d’éliminer une partie de la pression à laquelle est confronté le système de santé mondial, en fournissant des connexions et un accès aux professionnels de la santé et aux patients.

De même, l'utilisation d'une solution de suivi et de traçabilité des actifs pour gérer les dispositifs médicaux permet de nouvelles capacités significatives, notamment :

La gestion sécurisée des appareils qui protège les actifs en provisionnant, gérant et retirant automatiquement et en toute sécurité les appareils IoT sur l'ensemble d'une base d'actifs.

L'intégration de l'écosystème qui fournit un flux d'informations transparent à travers les solutions de la chaîne d'approvisionnement de l'entreprise, permettant l'échange sans friction d'informations basées sur des capteurs avec des systèmes d'entreprise clés.

La messagerie unifiée qui regroupe les informations provenant de systèmes disparates et les combine pour créer un flux de données unique afin de permettre une communication de tout type.

Des informations exploitables qui appliquent l'intelligence artificielle et l'apprentissage automatique pour surveiller les conditions, stimuler les performances et maximiser la disponibilité des équipements et des actifs en état de marche, offrant ainsi une visibilité de bout en bout sur les actifs.

Malgré les défis auxquels le domaine de la santé est confronté, comme fournir un accès et des soins de qualité pour tous, la véritable promesse de ces avancées ne sera visible que si les organisations peuvent s'adapter à la mise en œuvre transparente de solutions technologiques. Pour de nombreuses organisations, cela signifiera devenir plus agiles et plus intelligentes en adoptant l'IoMT pour capturer les données à partir desquelles les connaissances et les soins peuvent être construits. »

Pourquoi marcher est-il si difficile pour un robot ?


robot

Par Ewen Dantec, INSA Toulouse

La robotique, ou de façon plus générale l’art de construire des automates, bercent nos imaginaires collectifs depuis plusieurs siècles déjà, de Talos, le géant de bronze des mythes antiques, au petit robot Astro d’Osamu Tezuka dont les aventures furent publiées de 1952 à 1968, en passant par le flûteur de Vaucanson construit au XVIIIe siècle, capable de jouer plusieurs airs différents sur une flûte traversière.

Les robots modernes, tels que nous pouvons en trouver dans les usines, sont en comparaison très récents puisque le premier d’entre eux, Unimate, n’a commencé à travailler qu’au début des années 60 sur les chaînes d’assemblage de General Motors. Et ce n’est en 1972 qu’est « né » WABOT-1, le premier robot anthropomorphe capable de marcher sur deux jambes, de percevoir son environnement à travers ses senseurs visuels et de transporter des objets dans ses mains.

Au-delà de l’intérêt scientifique du problème de la marche, le développement de la robotique à pattes est motivé par plusieurs applications prometteuses : le vieillissement de la population dans les pays aisés nourrit par exemple l’idée d’une aide médicale robotisée à domicile ; certaines tâches industrielles pénibles ou dangereuses pourraient être allouées à des robots marcheurs, plus versatiles et plus autonomes ; enfin, le secours de personnes en zone sinistrée pourrait être facilité par l’intervention de bipèdes agiles.

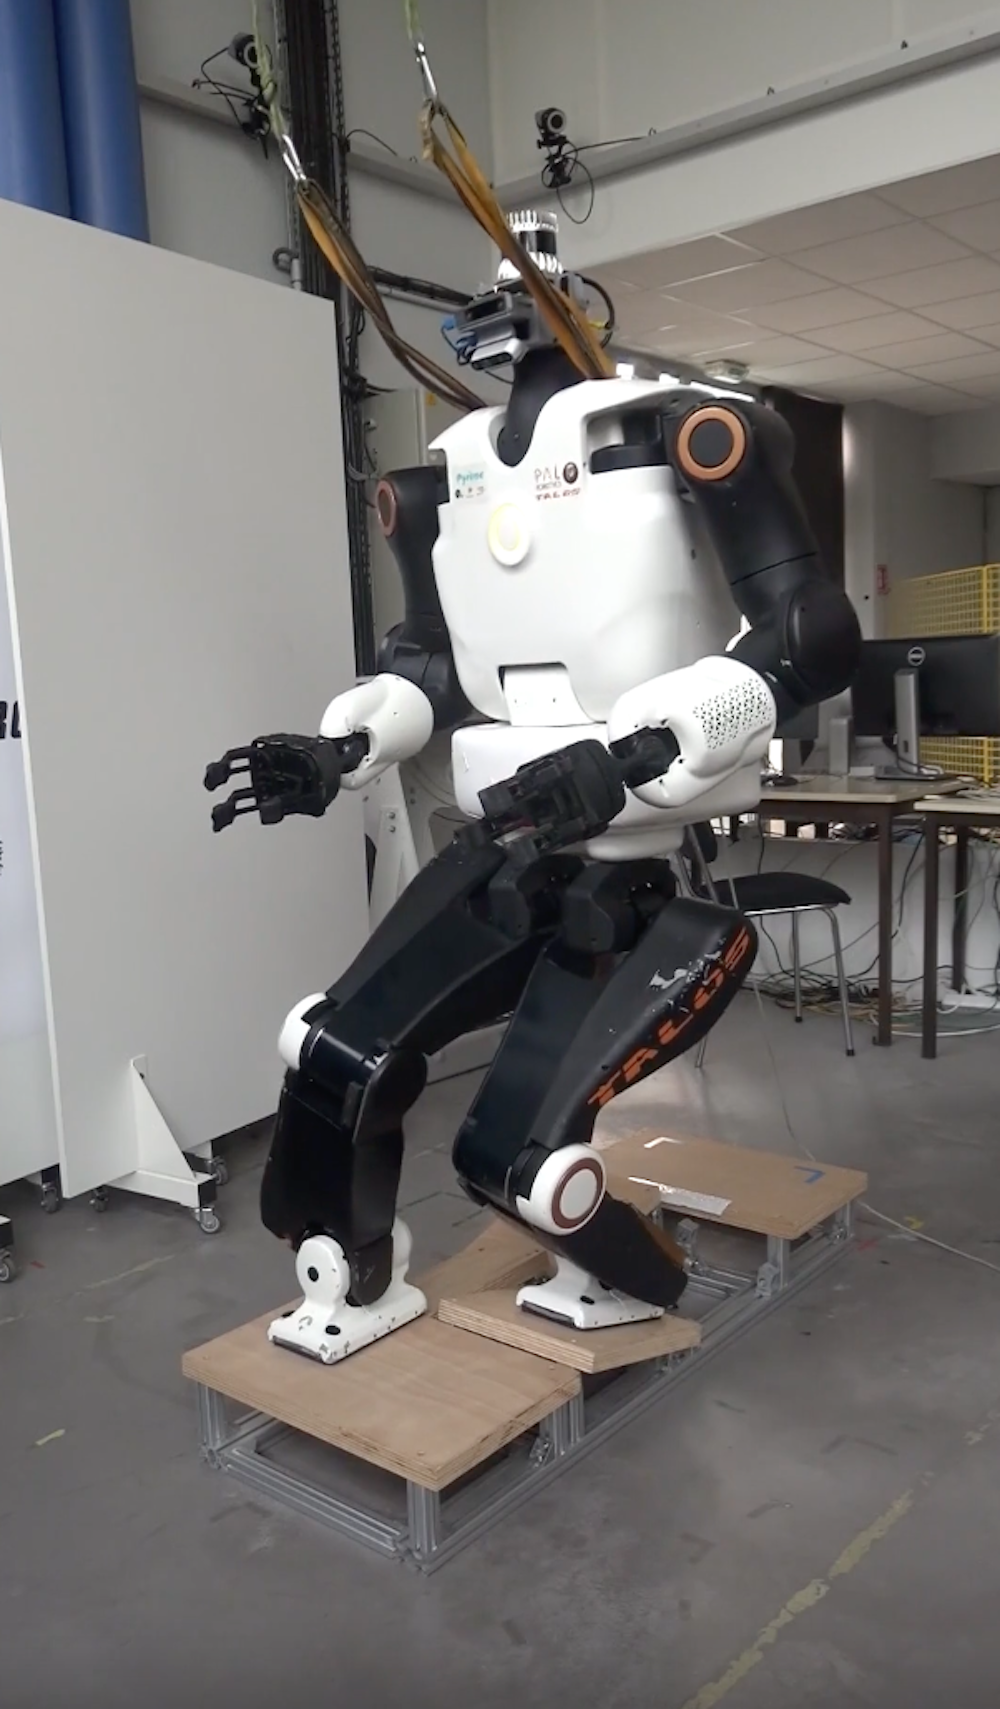
Un robot marche sur une plate-forme
Talos, un robot marcheur développé au laboratoire d’analyse et d’architecture des systèmes (LAAS), sur un terrain irrégulier. Ewen Dantec, Fourni par l'auteur

En effet, pour évoluer dans des environnements conçus pour les humains (avec des portes, des escaliers, des rambardes…), ces robots auraient tout intérêt à marcher comme nous.

Mais malgré les récents progrès de l’ingénierie, les robots marcheurs sont toujours rares – ce qui est étonnant, en particulier si l’on considère les progrès époustouflants dans des domaines adjacents, sur les capacités de maîtrise du langage des intelligences artificielles par exemple. Alors, pourquoi est-il si difficile d’apprendre à marcher à un robot ?

La bipédie, instinctive pour les vivants mais très complexe mathématiquement

Chez les êtres humains en bonne santé, marcher est un processus naturel auquel nous ne prêtons guère attention au quotidien. Les premiers pas d’un nouveau-né se font en général entre 10 et 18 mois, bien avant qu’il ne soit capable d’appréhender la mécanique sous-jacente de son déplacement. La capacité à se mouvoir sur deux pattes est une compétence que nous apprenons presque seul, en imitant notre entourage et en procédant par essai et erreur. Pour les animaux, les choses paraissent encore plus simples, puisque la majorité des quadrupèdes sont capables de marcher, sauter ou courir quelques heures seulement après leur naissance.

Cependant, la locomotion humaine est un problème extrêmement compliqué d’un point de vue mathématique, qui implique le contrôle en temps réel d’environ 360 articulations et 640 muscles, tout en tenant compte du centre de gravité, de l’équilibre, des appuis, de la vision…

Une compilation de robots qui chutent au « DARPA Robotics Challenge » (IEEE Spectrum).

En définitive, si la robotique à pattes donne de très bons résultats en laboratoire, là où les chercheurs peuvent contrôler précisément l’environnement expérimental, elle n’est pas encore assez robuste pour affronter le désordre et l’imprédictibilité du monde réel.

Diviser le problème pour mieux le résoudre

Les premiers résultats probants sur la locomotion bipède des robots ont été obtenus en décomposant le problème : planification d’une part et contrôle d’autre part.

Dans un premier temps, on calcule la trajectoire à exécuter en se basant sur des techniques d’optimisation qui vont minimiser un coût (par exemple, un temps de trajet d’un point A à un point B) sous certaines contraintes (par exemple, ne pas tomber). Dans un second temps, on exécute cette trajectoire et on s’assure que le robot la suit même en cas de perturbations extérieures ou d’erreurs.

[Près de 80 000 lecteurs font confiance à la newsletter de The Conversation pour mieux comprendre les grands enjeux du monde. Abonnez-vous aujourd’hui]

En effet, à ses débuts, la robotique ne disposait pas d’ordinateurs assez puissants pour faire de la planification complète en temps réel, comme les humains. Pour générer certains mouvements complexes, les algorithmes d’optimisation pouvaient prendre plusieurs secondes, voire plusieurs minutes, et il fallait planifier l’intégralité du mouvement à l’avance.

Prévoir ses mouvements comme le font les humains

L’inconvénient de cette approche est qu’elle ne permet pas au robot de modifier son comportement en cas de transformation soudaine de l’environnement (par exemple un humain qui passe devant lui, un objet qui tombe sur le chemin…) : le système essayera de suivre la trajectoire calculée quoiqu’il arrive.

On sait maintenant que les humains au contraire ne prennent en compte que leurs deux ou trois prochains pas quand ils évaluent leur trajectoire (soit une à deux secondes d’anticipation).

Les roboticiens ont donc simplifié le problème de planification, en ne regardant que des horizons temporels très proches, de façon à pouvoir le résoudre très rapidement. Cette méthode, baptisée « contrôle prédictif », consiste à calculer une trajectoire désirée pour le robot, dont seul le premier point sera utilisé, par exemple un pas. Une fois ce point réalisé, on recalcule la nouvelle trajectoire souhaitée en prenant en compte les nouvelles informations dont dispose le robot : vision, senseurs internes, consignes de l’utilisateur, et qui pourraient indiquer l’apparition d’un obstacle par exemple.

Le robot bipède Atlas et ses acrobaties. Source : Boston Dynamics.

Au cours des dernières décennies, la puissance de calcul des ordinateurs a grandement augmenté, rendant possible l’implémentation de modèles plus complexes. On peut aujourd’hui prendre en compte la dynamique complète du corps du robot à l’intérieur de l’horizon de prédiction. Les méthodes de contrôle prédictif sont notamment à l’origine des impressionnantes acrobaties du robot Atlas de Boston Dynamics.

Utiliser l’« apprentissage par renforcement » pour favoriser la locomotion

Malgré ses avantages, le contrôle prédictif reste limité par les contraintes temps réel de la locomotion, et par la taille importante du problème à résoudre.

Ainsi, les roboticiens s’intéressent depuis peu à l’« apprentissage par renforcement » et à son application pour le contrôle de la marche. L’idée consiste à fixer une fonction de récompense pertinente (par exemple, atteindre un objet derrière une porte fermée) et à laisser le robot se mouvoir sur simulateur jusqu’à ce qu’il parvienne, par essai et erreur, à trouver le comportement qui maximise sa récompense.

L’approche s’inspire largement de la façon dont les enfants apprennent à se mouvoir, d’abord par gestes hasardeux, puis de plus en plus précis, jusqu’à devenir naturels et sans effort. Malgré tout, l’apprentissage par renforcement demeure une technique coûteuse en termes de temps d’entraînement sur machine, et ses résultats sont parfois difficilement transposables à la réalité. C’est ce qu’illustre la démarche très instable calculée par l’IA DeepMind de Google, qui a appris à marcher par elle-même : la solution obtenue fonctionne bien en simulation mais échouerait très certainement si elle était implémentée sur un véritable robot.

D’autres travaux suggèrent de combiner contrôle prédictif et apprentissage par renforcement : l’idée est de construire hors ligne une mémoire du mouvement dans laquelle le contrôleur pourrait piocher pour accélérer sa convergence lorsqu’il rencontre une situation nécessitant une réaction vive et complexe, comme un pas sur le côté pour éviter de percuter une voiture. Dans ce contexte, le contrôle prédictif sert à adapter aux conditions présentes un mouvement déjà connu et acquis, qu’on n’a alors plus besoin de réinventer à partir de zéro.

Cette dialectique entre adaptation et mémoire rappelle beaucoup le fonctionnement de l’humain, qui prend d’autant moins de temps à accomplir une tâche qu’il a répété de nombreuses fois par le passé.The Conversation

Ewen Dantec, Doctorant en robotique au Laboratoire d'analyse et d'architecture des systèmes, INSA Toulouse

Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.

Le Groupe iliad prend une participation majoritaire au capital du toulousain ITrust

itrust

Le Groupe iliad, maison mère de Free et propriété de Xavier Niel, a annoncé ce mardi 4 avril une prise de participation majoritaire au capital d’ITrust, éditeur toulousain de technologies et société de services en cybersécurité fondée par Jean-Nicolas Piotrowski.

"Pure player français, ITrust est le seul acteur à proposer une plateforme de cybersécurité 100% propriétaire et 100% souveraine.  En s’appuyant sur le savoir-faire d’ITrust, Free Pro, filiale B2B du Groupe iliad, lance aujourd’hui son offre Cyber XPR pour démocratiser la cybersécurité auprès des entreprises. Fort d’une expertise développée au cours de ces quinze dernières années par son équipe de R&D, ITrust propose une solution de cybersécurité unique basée sur l’intelligence artificielle, 100 % souveraine et labélisée par l’ANSSI" indique un communiqué d'illiad.

Jean-Nicolas Piotrowski demeure actionnaire de l'entreprise

"Par la qualité et la fiabilité de ses services, ITrust a su gagner la confiance de plus de 400 clients dans le monde – dont 6 sociétés du CAC 40 en France - opérant dans divers secteurs, notamment dans des domaines d’activités sensibles comme, en France, le Ministère de la Défense ou encore une cinquantaine de groupes hospitaliers signés ces douze derniers mois.  En devenant actionnaire majoritaire d’ITrust, le Groupe iliad poursuit sa stratégie sur le marché des entreprises et répond à l’un des enjeux majeurs du secteur aujourd’hui : la cybersécurité. Partageant les mêmes valeurs d’innovation, de simplicité et l’esprit entrepreneurial de Free, le fondateur d’ITrust demeure actionnaire de l’entreprise.  

"Par cette acquisition, Free Pro, opérateur de services Télécoms et Cloud souverain, filiale B2B du Groupe iliad, conforte sa stratégie d’accompagner toutes les entreprises en leur rendant accessibles les innovations technologiques et lance aujourd’hui Cyber XPR, solution unique de protection face aux nouvelles menaces cyber", détaille le groupe illiad

"Avec cette acquisition, Free Pro poursuit le développement de son offre de services à l’attention de toutes les entreprises et des collectivités locales. ITrust entend être un véritable accélérateur pour le Groupe dans ce domaine stratégique de la cybersécurité. Avec ITrust, nous partageons l’esprit entrepreneurial et les valeurs d’innovation", déclare Thomas Reynaud, Directeur Général du Groupe iliad.

Bâtir une solution de cybersécurité 100% française 

"Face aux risques de cybermenaces, notre rôle est d’accompagner entreprises et collectivités dans l’adoption de solutions de protection de leurs infrastructures réseau et IT complètes et performantes. Avec ITrust et l’hébergement des données dans nos datacenters, nous mettons à disposition de nos clients la solution Cyber XPR, seule solution 100 % française à garantir le niveau de protection le plus élevé et la souveraineté totale. Nous nous donnons l’objectif que 100% de nos clients, de la petite entreprise ou collectivité à la plus grande organisation puisse disposer avec Free Pro d’une solution de cybersécurité adaptée. Proposer innovation, simplicité et tarif accessible reste le crédo de nos investissements pour tous nos clients. Cette offre est disponible dès aujourd’hui", explique Denis Planat, Directeur Général de Free Pro.

Intelligence artificielle et analystes

"Nous sommes fiers de rejoindre aujourd’hui Free Pro avec l’ambition de proposer à toutes les entreprises françaises une plateforme complète de cybersécurité. Notre solution, fruit de 15 années d’expérience, apporte une capacité de détection des menaces cyber connues et inconnues. L’analyse des menaces via une intelligence artificielle, couplée à l’expertise de nos cyber analystes, permet d’anticiper les attaques et de garantir la sécurité des infrastructures que nous manageons", explique Jean-Nicolas Piotrowski, Président-Fondateur d’ITrust.

ChatGPT : technologie de rupture ou simple buzz ?

Philippe Rioux

Chat GPT a atteint un million d'utilisateurs cinq jours seulement après sa création en novembre 2022. Lionel Bonaventure / AFP
Marion Trommenschlager, Université Rennes 2

Alors que l’impact de l’intelligence artificielle (IA) dans le monde du travail ou en matière de désinformation fait couler beaucoup d’encre, des dirigeants du secteur, dont Elon Musk, appellent à décélérer. Une intelligence artificielle ultra-médiatisée a tenu un rôle majeur dans l’ouverture de ces débats : ChatGPT. Mais a-t-elle vraiment créé une rupture ?

Il n’y a pas de réelle nouveauté technique dans ChatGPT. Son ancêtre, Eliza, date de 1966. La technique de codage, aussi sophistiquée soit-elle, s’inscrit dans une continuité des conceptions de langage de programmation. Par ailleurs, dans une approche sociologique, rappelons que nous sommes une humanité numérique, une société artefactuelle (puisque nous évoluons à travers le progrès technique), dans laquelle toute innovation s’inscrit dans une continuité.

Peut-on alors réellement parler d’innovation de rupture pour ChatGPT ?

Et s’il fallait finalement se saisir de ce raz de marée médiatique pour comprendre la fulgurance de son déploiement, et plus encore, pour comprendre où nous en sommes, nous, utilisateurs, dans nos représentations, entre fantasmes et réalités, de l’intelligence artificielle ?

Ces logiciels d’intelligence conversationnelle nous ramènent à deux grandes tendances liées à la technicisation de la société. Tout d’abord celle de la servicisation, c’est-à-dire une normalisation de l’assistance personnalisée au quotidien. Cette tendance est arrivée avec le passage d’une économie basée sur des logiques de masse, vers une autre basée sur des logiques individuelles.

Le second grand levier est la plateformisation : créés au sein d’empires numériques (entre autres GAFAM), ces logiciels sont pensés pour être infusés dans tout l’écosystème. C’est le cas par exemple de ChatGPT, amené à investir Bing, Outlook, et autres services de Microsoft.

Et pour cause, le disgracieux « GPT » dans sa version francophone, renvoie au « general purpose technologies », soit technologies à usage général. Il est donc de par sa nature, un outil conçu pour être facilement transposé et utilisé dans différents domaines. Différent d’un moteur de recherche, il répond à des questions complexes et cherche à comprendre l’intention.

[Près de 80 000 lecteurs font confiance à la newsletter de The Conversation pour mieux comprendre les grands enjeux du monde. Abonnez-vous aujourd’hui]

Comment expliquer l’appropriation si rapide de ChatGPT par les utilisateurs ?

L’impact médiatique relève du fait de ses utilisateurs. Comme souligné par l’anthropologue Lionel Obadia, il est difficile de parler d’invention. Néanmoins, la diffusion et l’appropriation remarquablement rapide font de ChatGPT une innovation marquante. Elle peut être utilisée par n’importe qui, initié ou non, gratuitement en ligne, et entraîne de ce fait autant de nouveaux usages, de contournements, que de business potentiels.

Trois forces expliquent la rapide intégration et appropriation sociale du logiciel.

Premièrement, ChatGPT est très accessible : ce qui lui permet un passage à l’échelle, autrement dit un déploiement, très rapide. L’accessibilité de l’outil et son appropriation généralisée massifient l’usage, mais également l’intérêt pour ce qui paraît « nouveau », voire « divertissant ».

Ensuite, ChatGPT nous ressemble. Le processus de machine learning en fait un outil d’auto-enrichissement continu, comme les humains. Le dialogue lui permet par exemple d’améliorer ses réponses avec un langage naturel. Ainsi, plus il est utilisé, plus il est performant. Autrement dit, nous nous « éduquons » mutuellement.

Enfin, ChatGPT est un champ des possibles : il laisse entrevoir de nouveaux scénarios. Nous sommes, en tant qu’utilisateurs, la condition pour la réussite du déploiement de ces innovations numériques. Chose faite pour ChatGPT qui compte à présent plus de 100 millions d’utilisateurs. Nous commençons à prendre conscience de « l’après » et de l’émergence d’autres innovations issues du modèle de ce logiciel.

La philosophe Marie Robert raconte son expérience lorsque le média Brut lui propose de corriger une copie rédigée par le logiciel :

« C’est avec un certain frisson que j’ai pris mon stylo rouge pour tenter de comprendre le raisonnement élaboré par une machine. Malgré une absence de citations, un manque cruel de nuances et une structure bien trop rigide, ma première remarque fut que ce n’était « pas si mal » […] C’est donc avec un mélange de fascination et d’effroi que j’ai terminé l’exercice, me demandant sincèrement ce que nous allions faire pour le monde à venir, pour ces générations qui n’auront pas à connaître l’effort. »

Des métiers de la cognition voués à disparaître ?

Ce qui diffère vraiment avec les précédentes évolutions liées à l’innovation, c’est que ChatGPT touche les métiers de la cognition, plutôt épargnés jusqu’alors. Il est d’ailleurs intéressant de rappeler que l’un des logiciels les plus (technologiquement) complexes, l’Autopilot de Tesla, a été pour 85 % fabriqué par l’intelligence artificielle. La dynamique d’hybridation entre métiers et intelligence artificielle est de plus en plus forte. Cependant, il serait fantasmé de parler de « grand remplacement ».

L’autonomie de l’intelligence conversationnelle n’est pas totale. Par exemple, ChatGPT développé par Open AI a été construit à partir de 175 milliards de paramètres, il s’appuie sur un jeu de données gigantesque. Gigantesque certes, mais sélectionné, donc faillible.

Récemment, des échanges et lectures sur l’art du codage m’ont permis d’éclairer plus encore les limites du mythe d’une autonomie de l’intelligence artificielle. Cela notamment à travers la dimension de labellisation dans les réseaux de neurones. Dans ce processus, il s’agit d’étiqueter des données, c’est-à-dire d’associer un label (une valeur prédéfinie) à un contenu (image, texte, forme, etc.). L’objectif est d’apporter un modèle d’apprentissage aux machines. Cette pratique rappelle la nécessité de paramétrage et de supervision dans l’interprétation des données, une réalité a (re) découvrir dans la mini-série documentaire Les travailleurs du clic de Antonio Casilli. Open AI a d’ailleurs différents contrats avec des travailleurs au Kenya pour ce travail de modération.

Bande annonce Invisibles. Les travailleurs du clic d’Antonio Casilli.

Nous voyons donc les limites d’un fantasme autour d’une intelligence artificielle parfaitement autonome.

Bien que l’intelligence artificielle ne comprenne pas ce qu’elle dit, ces implications humaines dans la supervision de l’apprentissage des machines nous montrent que les données qui nourrissent cette intelligence, elles, ne sont pas neutres. Elles reproduisent et amplifient les biais de ceux qui la supervisent, chariant un lot potentiel de stéréotypes, de désinformation, de contenus aspirés aux sources invisibles, de censure, ou encore de complotisme (Meta en a fait l’expérience avec Blender bot 3).

La question centrale est donc : qui paramètre ? Le professeur de droit Lawrence Lessig le souligne dans son clairvoyant « Code is law » : la personne qui paramètre est la personne qui a la possibilité d’orienter un système de pensée. Un outil comme ChatGPT est principalement conçu par et pour une cible nord-américaine. Son déploiement rapide, renforcé par sa dimension ludique, conduit à la normalisation de son utilisation. Une normalisation non pas sans effet, puisqu’elle vient renforcer l’impression d’un objet politiquement neutre chez les utilisateurs.

Or, c’est loin d’être le cas, pour les raisons évoquées précédemment, mais aussi parce que l’IA est avant tout un enjeu de domination tant entre empires du numérique, que dans la sphère géopolitique.The Conversation

Marion Trommenschlager, Chercheure en sciences de l'information-communication, laboratoire PREFics, Université Rennes 2

Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.

Pourquoi il fallait encadrer davantage la publicité faite par les influenceurs

reseauxsociaux

Par Florence Euzéby, La Rochelle Université; Juliette Passebois-Ducros, Université de Bordeaux et Sarah Machat, La Rochelle Université

En 2021, un internaute sur 4 déclarait suivre un influenceur sur les réseaux sociaux, et parmi eux 3 sur 5 reconnaissaient suivre leurs recommandations d’achat. Désormais entré dans le langage courant (66 % des Français déclarent savoir ce qu’est un créateur de contenu), l’influenceur est une personnalité suivie par un grand nombre de followers sur TikTok, Instagram, Facebook, YouTube ou autre réseau social et reconnue comme ayant un pouvoir de recommandation et de persuasion sur une thématique (mode de vie, gastronomie, sport, beauté́, etc.).

Fort de ce pouvoir de prescription, ces influenceurs sont devenus de véritables ambassadeurs pour les marques. Adidas et Lena Situation ou encore Celio avec MacFly et Carlito, etc. les exemples sont nombreux. Les investissements des marques dans le « marketing d’influence » sont de plus en plus conséquents. Ce marché représenterait en France 15 milliards d’euros en 2022.

Mais parce que cette pratique est nouvelle et le secteur encore peu réglementé, on observe le meilleur comme le pire. Publicité déguisée, pratiques commerciales trompeuses, escroqueries, abus de confiance, promotions pour la contrefaçon et « dropshipping » sont quelques exemples qui font régulièrement la une des médias.

Une riposte aux « influvoleurs »

Parce qu’ils font figure d’autorité, qu’ils sont perçus comme des modèles de réussite pour les plus jeunes, et qu’ils paraissent crédibles et experts, les internautes se laissent facilement séduire par leurs discours et parfois abuser par ces influenceurs en suivant leurs recommandations aveuglément. Les abus sont tels que des collectifs de victimes ont vu le jour comme « AVI » (Aide aux victimes d’Influenceurs) pour protéger les consommateurs et accompagner les victimes dans leurs démarches judiciaires.

Le gouvernement français s’est récemment saisi de cette question. Pour le ministre de l’Économie et des Finances, Bruno Le Maire :

« Le secteur de l’influence commerciale […], alors qu’il est un formidable vecteur de créativité et de richesse économique, ancré dans le quotidien de millions de nos compatriotes […] souffre de règles inexistantes ou trop floues ».

Après avoir lancé une grande concertation nationale sur cette question fin 2022 (19 000 participants), le ministère a proposé 13 mesures et élaboré un code de bonne conduite pour les influenceurs. L’objectif affirmé est d’accompagner les influenceurs et de mieux protéger les consommateurs contre les « influvoleurs ».

Le gouvernement rejoint ainsi un combat porté par le rappeur Booba depuis plusieurs mois. Le 13 mars dernier, Bruno Le Maire a ainsi affirmé qu’il avait « raison ».

Du côté de l’Assemblée nationale, une proposition de loi transpartisane, portée par les députés Arthur Delaporte (Parti socialiste) et Stéphane Vojetta (Renaissance), a été adoptée à l’unanimité le jeudi 30 mars. Elle vise elle aussi à réguler l’activité d’influence commerciale par voie électronique, à travers « un texte responsabilisant, pédagogique mais également sanctionnant ».

Les mesures, élaborées après concertation de certains influenceurs (ce qui a fait polémique dans le milieu, comme le rappelle l’influenceur Squeezie dans la vidéo ci-dessous), couvrent plusieurs domaines : interdiction pure et simple de faire la promotion de certains produits et pratiques (chirurgie esthétique, médicaments, jeux d’argent et paris en ligne, etc.), obligation de déclaration des revenus générés par les partenariats publicitaires mais aussi transparence accrue des partenariats publicitaires.

Cette proposition vient renforcer l’obligation déjà existante de mentionner de façon claire et explicite l’intention commerciale des publications lorsque les publications des influenceurs sont sponsorisées par une entreprise.

Pourquoi, dès lors, renforcer cette obligation ? Quels sont les objectifs sous-jacents de la divulgation du partenariat publicitaire ? Et quels effets observe-t-on lorsque l’influenceur divulgue qu’il s’agit d’un partenariat publicitaire ?

Moins d’un influenceur sur deux en conformité

En dépit de la loi et de l’amélioration des pratiques, les influenceurs respectent peu ou mal cette obligation. L’Autorité de régulation de la publicité professionnelles (ARPP) s’est emparée de ce sujet dès 2020 avec la mise en place d’un Observatoire de l’influence responsable. L’analyse des contenus des influenceurs sur 2021 met en avant une amélioration des pratiques de transparence des influenceurs.

[Près de 80 000 lecteurs font confiance à la newsletter de The Conversation pour mieux comprendre les grands enjeux du monde. Abonnez-vous aujourd’hui]

Néanmoins, seuls 47 % d’entre eux apparaissent comme pleinement conformes à la réglementation. De nombreux influenceurs, notamment des micro-influenceurs, mentionnent pas ou mal leurs partenariats. L’effort est donc à poursuivre et la nouvelle proposition de loi vise à non seulement renforcer les obligations mais aussi à sanctionner davantage les manquements à la loi.

La divulgation claire et explicite du partenariat est censée protéger le consommateur. En effet, les autorités publiques font l’hypothèse qu’un consommateur informé du caractère commercial d’un contenu saura mieux se protéger et répondre de manière plus éclairée, plus critique au message.

Ce mécanisme a été théorisé dans les années 1990 par les chercheurs Marian S.Friestad et Peter Wright. Dans leur modèle « Persuasion Knowledge », lorsque les individus perçoivent le caractère commercial d’un message, ils comprennent qu’il s’agit d’une tentative de persuasion et activent leur « connaissance de la persuasion et des tactiques persuasives » pour ajuster leurs attitudes et intentions vis-à-vis du produit promu. Ainsi, ils doutent de l’objectivité de l’argumentation et sont plus critiques.

Dans le contexte des réseaux sociaux, les influenceurs sollicités par les marques créent des publications dans lesquelles ils vantent ou testent des produits qui, sur le fond et sur la forme, ressemblent à des contenus publiés hors de tout partenariat publicitaire. Il est donc très difficile pour les consommateurs de distinguer les contenus publicitaires et non publicitaires si la mention d’un partenariat (par exemple, « sponsorisé par » ou « #partenariat avec ») n’est pas présente.

Des effets paradoxaux sur les internautes

Dans ce contexte, il a été démontré que la mention claire et explicite du partenariat facilite la reconnaissance du caractère publicitaire. Inversement, lorsque le partenariat n’est pas annoncé ou l’est de manière floue, cela nuit à la reconnaissance du caractère commercial de l’annonce. C’est bien le sens de l’article 2C-I de la proposition de loi évoquée précédemment qui indique que :

« La promotion de biens, de services ou d’une cause quelconque réalisée par les personnes mentionnées à l’article 1er les [influenceurs] doit être explicitement indiquée par une mention claire, lisible et identifiable sur l’image ou la vidéo durant l’intégralité de la promotion ».

« La violation des dispositions prévues au présent article est punie d’un an d’emprisonnement et de 4 500 euros d’amende ».

Cependant, les travaux menés en marketing et dans divers domaines, avec des influenceurs plus ou moins populaires, fictifs ou réels, ne sont pas unanimes quant à l’effet de cette reconnaissance sur les réactions des internautes. Il peut dépendre par exemple de l’argumentation plus ou moins nuancée adoptée par l’influenceur dans sa recommandation. Dans un récent article publié dans la revue Recherche et Applications en Marketing, nous montrons que l’effet évoluerait aussi en fonction du type d’influenceur : micro (moins de 10 000 abonnés) ou méso-influenceur (entre 10 000 et 1 million d’abonnés).

Enfin, des études soulignent des effets contraires et paradoxaux de la divulgation. C’est ce que certains auteurs appellent le « paradoxe de la transparence ». L’influenceur serait ainsi jugé plus transparent, plus honnête, plus digne de confiance et plus attractif, compte tenu de sa capacité à attirer des partenariats. La marque bénéficierait également de cette divulgation en renforçant, par exemple, sa mémorisation.

Vers une influence responsable

Ainsi, si la mention claire et explicite du partenariat facilite la reconnaissance de l’intention publicitaire, rien ne garantit que celle-ci soit de nature à amoindrir les intentions des consommateurs vis-à-vis du produit ou des marques. Sous certaines conditions, l’internaute apparaît comme un influencé consentant, qui n’a pas de réticences particulières vis-à-vis des publicités portées par des influenceurs.

Dans une récente étude, près de 80 % des personnes interrogées indiquent être conscientes des opérations de partenariats réalisées, elles sont 54 % à les accepter sans problème. Elles sont toutefois 70 % à exiger la transparence sur ces partenariats. L’internaute souhaite donc être un consommateur influencé consentant mais éclairé.

Les marques ont d’ailleurs compris les enjeux de la transparence et certains annonceurs exigent que les influenceurs soient certifiés « influence responsable », formation dispensée par l’ARPP depuis septembre 2021. L’Oréal France ou Club Med, ont par exemple indiqué qu’ils ne collaboreraient à l’avenir qu’avec des influenceurs certifiés.

Le marketing d’influence ne pourra ainsi gagner ses lettres de noblesse que par des pratiques transparentes qui ne tirent pas leur efficacité d’une « omission trompeuse » de sa nature véritable, mais d’une réelle valeur ajoutée de la créativité des influenceurs, raison pour laquelle les annonceurs font appel à eux.The Conversation

Florence Euzéby, Maitresse de conférences en sciences de gestion, IAE La Rochelle, La Rochelle Université; Juliette Passebois-Ducros, Enseignant chercheur en marketing, IAE de Bordeaux, Université de Bordeaux et Sarah Machat, Maitresse de conférences en Marketing, La Rochelle Université

Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.

Avec France identité, bientôt votre carte d’identité sera sur votre smartphone

smartphone

C’est l’un des plus petits pays de l’Union européenne avec 1,33 million d’habitants, mais l’Estonie fait figure de géant et de modèle dans le monde entier lorsque l’on parle d’identité numérique. Le pays a même été classé « société numérique la plus avancée au monde » par le magazine spécialisé Wired. Indépendant depuis 1991 et membre de l’UE depuis 2004, l’Estonie, en effet, a très tôt misé sur la numérisation de son économie et de son administration. Au centre de son écosystème, une carte d’identité numérique obligatoire.

En Estonie, la carte d'identité jalonne la vie démocratique

A sa naissance, chaque Estonien se voit attribuer un identifiant national en ligne qui lui permettra d’obtenir, à son quinzième anniversaire, cette carte d’identité numérique véritable sésame pour prouver son identité physiquement ou sur internet pour accéder à de multiples services. Voter en ligne, (depuis 2005 !), accéder aux transports en commun, payer ses impôts, communiquer avec l’école de ses enfants, demander des subventions, gérer sa santé (les ordonnances médicales sont dématérialisées), etc.

carte

Au total, 1 500 services sont ainsi accessibles de manière sécurisée. L’Estonie, dont le modèle inspire des initiatives partout dans le monde et notamment en Afrique, permet également aux étrangers de devenir des « e-citoyens » . Depuis 2014, on peut ainsi accéder à une foule de service à l’exclusion des services civiques bien sûr.

Le revers de la médaille est bien sûr la vulnérabilité accrue aux cyberattaques. En 2007, le pays a subi et résisté à des attaques venant de Russie. Idem l’été dernier dans le contexte de la guerre en Ukraine. Mais pas de quoi décourager l’Estonie, dont le modèle continue à inspirer nombre de pays dont la France.

En France, les retards de l’application France identité

Le 15 mars 2021, une nouvelle carte d’identité au format « carte bancaire » est progressivement entrée en circulation en France. Il était temps, la France est l’un des derniers pays européens à avoir adopté la carte nationale d’identité électronique (CNIe). Dotée d’une puce, comme la carte d’identité estonienne, cette carte biométrique est beaucoup plus sécurisée que l’ancienne. Elle doit aussi se doubler d’une application numérique, France identité, à installer facultativement sur son smartphone.

franceidentité

Cette application chargera (via la puce NFC du smartphone) les informations d’identification contenues dans la puce de la carte d’identité (nom, prénoms, date et lieu de naissance, nationalité, sexe, adresses postales et mail, photographie), sauf les empreintes digitales. Ces informations permettront ensuite l’authentification et la connexion aux services, dont le millier qui utilise déjà FranceConnect.

Mais le test de cette application a pris du retard. Si les 2 500 testeurs qui utilisent la version Android n’ont pas rencontré de souci particulier, les 2 500 autres qui ont donc installé la version pour iOS, le système des iPhone, cumulent les bugs. En cause, la diversité des iPhone et le verrouillage pointilleux de la puce NFC par Apple. Un problème en cours de résolution.

L’Agence nationale de sécurité des systèmes d’information (Anssi) est par ailleurs toujours en train de vérifier le code source de l’application dont le nombre de testeurs va atteindre 20 000. Le gouvernement décidera ensuite de la date officielle de lancement.


Utiliser les objets connectés au réseau mobile pour optimiser le fret routier


Le fret routier a de nombreux impacts. Comment les limiter? Liquid Oh, Flickr, CC BY-NC-SA
Par Rémy Scholler, Orange; Eric Ballot, Mines Paris et Jean-François Couchot, Université de Franche-Comté – UBFC

En France, 90 % du transport interne des marchandises est effectué par la route et engendre plus de 9 % des émissions nationales de gaz à effet de serre. Notre dépendance au secteur des transports routiers conditionne l’aménagement du territoire, les infrastructures, les réglementations, et l’action politique.

À cause de son impact climatique, ce secteur – et les services qu’il remplit – est appelé à se transformer. Pour cela, il faudrait comprendre finement les activités de transport routier de marchandises et leurs flux sur le territoire. Par exemple, les entrepôts et les zones logistiques sont-ils répartis et utilisés de manière optimale ? Quelles sont les priorités à établir pour réduire l’empreinte carbone de ces activités ? En optimisant et mutualisant les chargements, les parcours ? Comment favoriser les modes de transport moins polluants (train, fluvial, véhicules électriques) ? Quels effets attendre d’un changement de réglementation ? Comment dimensionner les infrastructures de demain ?

Carte des flux de camions générée grâce au suivi d’objets connectés
En suivant les objets connectés dans des poids lourds, on peut reconstruire le flux de camions correspondant à l’origine Bourgogne Franche-Comté, la destination Nouvelle-Aquitaine, et transitant par la région Auvergne-Rhône-Alpes : ici, la route la plus empruntée est la route centrale européenne atlantique, une des départementales les plus accidentogènes de France. Les autoroutes bien connues (passant par Clermont-Ferrand ou Lyon) sont utilisées aussi, mais c’est secondaire pour l’origine-destination considérée. Équipe « Flux logistiques », Orange Innovation, Fourni par l'auteur

Pour répondre à toutes ces questions, il est utile de connaître, en temps réel, la répartition des véhicules de fret routier sur le territoire. Le problème, c’est qu’il existe peu de données concernant ce secteur, contrairement au fret aérien ou maritime : ces deux derniers sont moins morcelés, et pour des raisons de sécurité, les positions sont connues, ce que l’on peut visualiser notamment via les plates-formes Flightradar24 ou MarineTraffic.

Pour le fret routier en France, les rares études statistiques sont souvent annuelles et nationales (déclarations des transporteurs, collectées et mises en forme par l’Insee et DataLab). Elles représentent l’état du secteur mais ne donnent pas d’information du trafic en temps réel. D’autres études se font à l’échelle locale (enquête ou boucle de comptage) et sont utilisées pour mesurer le transport de marchandises dans une agglomération ou les effets de différentes mesures (livraisons de nuit, autorisations de véhicules, heures de livraison, zones de stationnement).

Mais globalement, la quantité et la qualité des données disponibles à propos du transport routier de marchandises restent faibles par rapport à l’impact qu’a l’activité sur la société. Ceci limite l’efficacité des décisions d’investissement ou de réglementation, qui peuvent être parfois dépassées dès leur mise en œuvre à cause du manque de données en temps réel ou d’une vision trop locale.

Comment compter les camions 24 heures sur 24 à l’échelle d’un pays ?

On peut utiliser des technologies in situ, par exemple des détecteurs le long de la route, et les technologies de collecte et d’analyse de « Floating Car Data », avec par exemple les données GPS ou cellulaires.

Les données GPS permettent une localisation et une estimation de vitesse précises et de plus en plus de véhicules en sont équipés mais elles restent assez peu accessibles (car sensibles pour les entreprises).

Les données cellulaires compensent leur faible précision notamment en s’appuyant sur un grand nombre de dispositifs répartis sur l’ensemble du territoire et il est possible de construire des indicateurs généraux de mobilité, notamment grâce à leur volume important.

[Près de 80 000 lecteurs font confiance à la newsletter de The Conversation pour mieux comprendre les grands enjeux du monde. Abonnez-vous aujourd’hui]

Orange, avec le projet « Flux logistiques », tente d’établir un observatoire du transport routier de marchandises, reposant sur l’analyse anonymisée de données de signalisation mobile. Le but est de fournir, en temps réel, des statistiques sur les flux de véhicules de fret routier respectueuses de la vie privée et du secret des affaires.

Nous exploitons les données des objets connectés au réseau Orange, par exemple des modems et applications embarqués dans des poids lourds ou des véhicules utilitaires légers (qui font partie d’une flotte d’entreprise pour la majeure partie d’entre eux), mais pas les données des smartphones.

Cette exploitation se fait en conformité avec le cadre réglementaire de traitement des données personnelles en France : les clients seront informés mais il n’est pas nécessaire de demander le consentement dans un cas comme celui-là, car nous anonymisons les données « à bref délai » (dans les minutes qui suivent leur collecte), respectant ainsi les préconisations de la CNIL.

Origines et destinations des camions dans le sud-ouest de la France, visualisées en suivant les objets connectés dans des poids lourds. On retrouve les deux principales zones d’entrées et sorties vers l’Espagne. L’échelle spatiale correspond à environ 1/8ᵉ de département et l’épaisseur des arcs en orange est proportionnelle au nombre de poids lourds effectuant l’origine-destination correspondante. Équipe « Flux logistiques », Orange Innovation, Fourni par l'auteur

Visualiser des flux de camions à partir de données du réseau mobile

Nous commençons par la construction d’une base de données expérimentale, à durée de vie limitée, au sein de laquelle l’identifiant de chaque objet connecté est supprimé et remplacé par un pseudo unique. Les données que nous utilisons correspondent principalement aux localisations des différentes antennes auxquelles les objets se connectent au cours du temps.

À l’aide de ces données, on détermine par exemple des vitesses, des directions de déplacements, ou des routes empruntées. Pour ne conserver que les objets embarqués dans des camions, nous utilisons des méthodes de « clustering ». Puis, nous déterminons les flux de camions dans une zone géographique pendant une certaine durée (origines et destinations).

Anonymiser les données

Pour des questions éthiques et légales de protection de vie privée et du secret des affaires, nous appliquons de manière simultanée un algorithme d’anonymisation irréversible, basé notamment sur le k-anonymat et la differential privacy, ce qui garantit l’anonymat des données calculées et permet de les protéger de tout type d’attaque.

Cela permet de respecter les exigences du RGPD et de la directive européenne « Vie privée et communications électroniques » en Europe, et plus particulièrement en France de leurs déclinaisons légales dans la Loi Informatique et Libertés et dans le Code des Postes et Télécommunications Électroniques.

L’idée du clustering est de créer des groupes de véhicules du même type (poids lourd, véhicule utilitaire léger) ayant un comportement similaire (transport longue distance, tournées, trajet, etc.), et de publier le nombre de véhicules présents dans chaque groupe. Cela permet d’éviter de publier des données concernant un véhicule en particulier, ce qui est illégal. De plus, il est nécessaire de bruiter les statistiques calculées, de sorte à les rendre inattaquables, par exemple en modifiant légèrement le nombre de véhicules présents dans les groupes, tout en conservant le bon ordre de grandeur.

Extrapoler les statistiques

La dernière étape consiste à extrapoler le nombre de camions détectés sur le réseau Orange, pour obtenir une bonne approximation du nombre de camions réel. Cette dernière étape est faite à l’aide d’autres sources de données nous donnant le nombre réel de camions à certains endroits du territoire, comme des photos satellites, ou des stations de comptage. Ces sources ne sont pas accessibles en temps réel, un satellite remontant typiquement une photo par jour.

Comment ces données pourraient aider à limiter les impacts du fret routier

Le but de ce projet est de fournir des statistiques en temps réel pour que les acteurs du fret routier puissent améliorer le fonctionnement de ce secteur et en limiter les impacts (empreinte carbone, pollution sonore, stationnement, congestion, etc.) par des actions collectives conduisant à des véhicules mieux remplis, des trajets plus courts ou des reports modaux. Les enjeux sont considérables quand on sait qu’il existe 20 % de kilomètres à vide et des taux de remplissage de l’ordre de 65 % pour les camions en Europe.

De telles données pourraient aider à positionner des hubs de transfert de marchandises sur des flux compatibles entre la route et le ferroviaire ou le fluvial. Les expéditeurs pourraient se servir de ce type de données pour découvrir ces potentiels et mutualiser leurs chargements.

Les collectivités acteurs de l’aménagement du territoire entreraient dans des boucles d’apprentissage renforcées et rapides en mesurant beaucoup plus rapidement (grâce à ces nouvelles statistiques en temps réel) l’effet d’une nouvelle réglementation sur les trajets, les temps de parcours pour les livraisons ou les places de parking en ville.

Dans le cadre de la transition énergétique, les travaux en cours permettront, par la connaissance du nombre des trajets, des arrêts et de leurs horaires, de quantifier les besoins énergétiques sur les principaux axes de circulation. L’identification de véhicules électriques pourrait aider à mieux positionner les bornes de recharge et le dimensionnement du réseau électrique par une connaissance plus fine de la dynamique des besoins.

Ces observations du trafic ouvrent aussi la voie à d’autres applications : comment, à partir de telles statistiques anonymes représentant des quantités de déplacement, modéliser les émissions de gaz à effet de serre ? Pour notre équipe, il s’agira d’établir un état de l’art critique de ces modèles, d’effectuer une première implémentation et de chercher à la valider avec des données de référence. Ces travaux sont engagés depuis le début de l’année 2023.The Conversation

Rémy Scholler, Doctorant Data Science, Protection des Données Personnelles, Logistique & Étude de la mobilité, Orange; Eric Ballot, Professeur, chaîne logistique, Mines Paris et Jean-François Couchot, Professeur des Universités en Informatique, Université de Franche-Comté – UBFC

Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.
Intelligence artificielle : le syndrome Frankenstein ou quand les professionnels de l’IA appellent à être régulés


IA

Par Constantin Pavléas, avocat spécialisé en droit des technologies, fondateur et dirigeant du cabinet Pavléas Avocats et responsable d'enseignements à l'école des Hautes Études Appliquées du Droit (HEAD).

Plus de mille trois cents chercheurs et entrepreneurs des nouvelles technologies, dont Elon Musk, fondateur de Tesla et de SpaceX et cofondateur de OpenAI, ou encore Steve Wozniak, le cofondateur d’Apple, ont signé  une lettre ouverte appelant à un moratoire d’au moins 6 mois sur le développement d’Intelligences Artificielles géantes plus fortes que ChatGPT-4.  

Ces experts du secteur craignent en effet une perte de contrôle suite aux progrès fulgurants à la suite de la mise en ligne de ChatGPT4 ou les nombreuses images générées par des IA qui peuvent se révéler des armes de désinformation massive et une menace pour nos sociétés et l’humanité. Ils appellent les laboratoires et à fixer les règles du jeu communes, des protocoles de sécurité pour la conception de ces systèmes et des audits indépendants pour les contrôler. Ils souhaitent que ces systèmes soient « exacts, sûrs, susceptibles d’interprétation, transparents, robustes, alignés, dignes de confiance et loyaux. »   Ils demandent aux politiques d’accélérer la mise en place de systèmes de gouvernance pour réguler la conception et l’usage de ces IA.  

Contrairement à ce qui a pu être écrit, les auteurs de cette lettre ne demandent pas de suspendre la recherche ou l’innovation. Ils demandent un temps de réflexion et d’action politique, un « Eté de l’IA » afin que la société ait le temps de s’adapter. Comme nos sociétés ont su le faire dans d’autres domaines, comme les biotechnologies, pour ne pas cloner l’être humain par exemple.  

La situation est assez surréaliste : dans une sorte de syndrome Frankenstein, les concepteurs tirent la sonnette d’alarme avant que leur création, cette « boite noire », n’échappe à tout contrôle. 

Cet appel s’adresse donc tout autant aux entreprises qu’au politique et au citoyen. 

Est-ce qu’il sera entendu par les entreprises telles OPenAI qui a pris de l’avance sur ses concurrents, mais dont son PDG exprime de même ses craintes quant aux usages de son produit à des fins de désinformation et de cybercriminalité ? 

Qu’en est-il du politique et de la réglementation juridique ? Depuis avril 2021, l’Europe travaille sur une proposition de Règlement sur L’intelligence Artificielle (EU IA Act). Ce texte n’est pas encore finalisé.  

Le projet d’IA Act distingue les IA interdites des « IA à haut risque » qui devraient obéir à des règles de sécurité, de conception et de gouvernance. il n’est pas clair si les IA génératives, telles que ChatGPT soient considérées comme des IA à haut risque, alors que précisément elles posent des problématiques qui sont des enjeux civilisationnels.  

Il est urgent que l’Europe revoie ce texte à l’aune des enjeux des IA génératives et le promeuve comme un standard à l’échelle du monde. 

OpenText publie son rapport 2023 sur les menaces de cybersécurité

hacker

OpenText vient de publier les résultats du rapport 2023 sur les menaces de cybersécurité d'OpenText qui explore les dernières menaces et les risques pour les segments des petites et moyennes entreprises (PME) et des consommateurs. Alimenté par la plateforme de renseignement sur les menaces BrightCloud, le rapport annuel d'OpenText Cybersecurity décompose un large éventail d'activités de menace, propose un aperçu des tendances observées et discute des impacts de grande portée pour les industries, les pays, les entreprises et les individus.

Les acteurs de la menace ont redoublé d'efforts dans leurs tactiques de longue date tout en faisant preuve d'innovation avec de nouvelles techniques. L'une des tendances notables de l'année dernière est l'augmentation significative de la dissimulation de l'emplacement des URL hébergeant des logiciels malveillants et des sites d'hameçonnage. Le pourcentage d'URL malveillantes cachées derrière un proxy ou un service de masquage de géolocalisation a augmenté de 36 % d'une année sur l'autre. Parallèlement, les menaces de cybersécurité en ligne continuent d'émerger à un rythme alarmant. De nouveaux sites web malveillants sont mis en ligne quotidiennement, tandis que des sites légitimes sont parfois compromis et cooptés à des fins malveillantes.

"Les cybercriminels, y compris les États, sont toujours aussi actifs, innovants et efficaces. Il y a cependant des nouvelles encourageantes. La baisse des infections par des logiciels malveillants indique que les mesures de sécurité globales sont efficaces", analyse Prentiss Donohue, vice-président exécutif d'OpenText Cybersecurity. Reconnaître les risques et se préparer en conséquence avec une approche multicouche de la protection des données sont des plans d'action recommandés pour les entreprises de toutes tailles."

Les principaux points du rapport 2023


Logiciels malveillants (Malware) 
  • Les logiciels malveillants sur les terminaux continuent de diminuer de 16,7 % par rapport à l'année précédente.
  • Pourtant, les tensions géopolitiques croissantes continuent d'influencer les campagnes de logiciels malveillants.
  • L'industrie manufacturière reste la première cible verticale
  • En analysant les URL à haut risque, on constate qu'en moyenne, chaque domaine malveillant héberge 2,9 URL de logiciels malveillants, contre seulement 1,9 URL d'hameçonnage.
Hameçonnage 
  • L'hameçonnage par courrier électronique est le principal vecteur d'infection, suivi par le protocole de bureau à distance (RDP) ; le RDP était le premier vecteur d'infection l'année dernière.
  • Plus d'un milliard de courriels non désirés sont classés comme étant des courriels de phishing.
  • Le trafic d'e-mails de spear phishing a augmenté de 16,4 % et représente désormais environ 8,3 % de l'ensemble du trafic d'e-mails.
  • Augmentation de 55,5 % des attaques de phishing par HTTPS par rapport à http
Ransomware
  • La double extorsion par exfiltration de données est courante dans les campagnes, avec un taux de 84 %.
  • Le montant médian des paiements effectués pour des ransomwares est passé de 70 000 dollars l'année dernière à près de 200 000 dollars.
  • La répression des ransomwares a connu un certain succès, mais n'a pas encore eu d'impact significatif sur la menace globale que représentent les ransomwares.

Taux d'infection
  • 28,5 % des entreprises disposant de 21 à 100 points d'accès protégés ont été touchées par une infection en 2022.
  • Pour les entreprises ayant entre 1 et 20 points d'extrémité, le taux est de 6,4 %.
  • Pour les entreprises ayant entre 101 et 500 points d'extrémité, le taux est passé à 58,7 %.
  • Et pour les 501+, le taux est de 85,8 %.
Répartition géographique
  • Les 50 000 adresses IP malveillantes les plus actives proviennent de 164 pays.
  • Les Pays-Bas et l'Allemagne figurent parmi les cinq premiers pays, de même que les États-Unis, la Chine et le Viêt Nam.
Défense multicouche
  • 40,3 % de réduction du nombre d'appareils ayant rencontré des logiciels malveillants pour les utilisateurs ayant adopté les trois couches de protection - Webroot SecureAnywhere, Webroot Security Awareness Training et Webroot DNS Protection - par rapport aux appareils utilisant uniquement Webroot SecureAnywhere.
  • Les données confirment que la cyber-résilience à l'aide d'une stratégie de défense à plusieurs niveaux reste la meilleure défense contre le paysage actuel de la cybercriminalité.

Découvrir le rapport complet 2023 OpenText Cybersecurity Threat report : 2023 Threat Report.


Journée mondiale de la sauvegarde des données informatiques : 3 questions à Patrick Sena

hdd

Ce 31 mars est la Journée mondiale de la sauvegarde des données informatiques. Patrick Sena, Senior Manager en Solution Engineering chez SailPoint répond à 3 questions sur l'importance de la sauvegarde.

Pourquoi sauvegarder ses données ?

La protection des données est désormais essentielle. Toute personne possédant un ordinateur portable, un smartphone ou un objet connecté n’est plus étranger quant à l’importance et la valeur de la sauvegarde des données et des fichiers. Elle est également vitale pour les entreprises. Une sauvegarde régulière - de préférence quotidienne - préserve les fichiers importants des pertes de données dues à des événements banals tels que les pannes de système, les logiciels malveillants, les bugs ou les pannes de disque dur.

Quels sont les risques pour les sauvegardes ?

Les attaques de cybercriminels sont de plus en plus complexes et difficiles à détecter et peuvent cibler directement les entreprises directement ou les sauvegardes. Les ransomwares, par exemple, peuvent crypter les données de sauvegarde lors de la phase finale de l'attaque, après être passés inaperçus pendant des mois. Cela peut empêcher les entreprises de se débarrasser complètement du virus et donc causer encore plus de dégâts.

Comment protéger ses sauvegardes et ses données ?

La sauvegarde des données est nécessaire, mais elle fait partie d’un pan plus large de protection des données des entreprises qui doit se faire sur plusieurs niveaux. L'authentification à deux facteurs pour toutes les données, y compris celles qui sont sauvegardées, est un indispensable.

Pour répondre à cette problématique, la sécurité et la gestion des identités est essentielle. Grâce à des solutions appropriées, les entreprises peuvent non seulement voir et comprendre qui accède à quels programmes et données, mais aussi attribuer les droits et les rôles d'accès en fonction de la tâche. Grâce à cette visibilité centralisée, les entreprises peuvent en outre réagir rapidement aux comportements suspects, bien avant qu'un incident ne se produise.

Données personnelles : rien à cacher, mais beaucoup à perdre

Nos données personnelles sont partout sur internet, et peuvent être utilisées à très mauvais escient. Дмитрий Хрусталев-Григорьев , Unsplash, CC BY
Par Antoine Boutet, INSA Lyon – Université de Lyon

Nos données personnelles circulent sur Internet : nom, adresses, coordonnées bancaires ou de sécurité sociale, localisation en temps réel… et les affaires qui y sont liées se font une place pérenne dans le débat public, du scandale Facebook-Cambridge Analytica au vol de données à la Croix-Rouge, en passant par les récents blocages d’hôpitaux par des rançongiciels (ou ransomware) et l’interdiction de l’application TikTok pour les fonctionnaires de plusieurs pays.

Mais si l’on sait de plus en plus que nos données personnelles sont « précieuses » et offrent des possibilités sans précédent en matière de commercialisation et d’innovation, il est parfois difficile de saisir ou d’expliquer pourquoi il faudrait les protéger.

Quels sont les risques liés à la divulgation de mes données personnelles ?

Le premier risque concerne la perte du contrôle sur nos propres données. C’est ce qui arrive par exemple quand on autorise le traçage par des sites ou des applications : on autorise l’enregistrement de nos activités sur le Web ou sur notre smartphone (pages visitées, géolocalisation) et l’échange de ces données, et, une fois cet accord donné, nous n’avons plus aucun pouvoir sur la circulation de nos données.

Ces informations sont utilisées le plus souvent pour du profilage qui permet d’alimenter l’économie de la publicité personnalisée régie dorénavant par des plates-formes d’enchères valorisant les données relatives aux profils utilisateurs contre des emplacements publicitaires.

Mais, ces informations peuvent également être utilisées à mauvais escient. La connaissance de votre localisation peut aider le passage à l’acte d’un cambrioleur par exemple, et la connaissance de vos centres d’intérêts ou opinion politique peut vous exposer à des opérations d’influence.

Le scandale Cambridge Analytica en est un exemple, avec l’exploitation de données personnelles de millions d’utilisateurs Facebook pour des campagnes de désinformation ciblées afin d’influencer des intentions de vote. Plus récemment, les révélations du Monde sur les entreprises de désinformation indiquent que cette pratique n’est pas un cas isolé.

Un autre risque concerne l’hameçonnage : si des informations personnelles sont présentes dans un courriel ou SMS frauduleux, il vous paraîtra plus réaliste et abaissera vos barrières de vigilance. L’hameçonnage sert souvent à infecter la cible avec un rançongiciel (ransomware en anglais) : les cybercriminels utilisent des informations personnalisées pour gagner la confiance des destinataires et les inciter à ouvrir des pièces jointes, ou à cliquer sur des liens ou documents malveillants, ce qui permet dans un second temps de verrouiller les données de la victime et d’en interdire l’accès. Une rançon est ensuite réclamée pour les déverrouiller.

[Près de 80 000 lecteurs font confiance à la newsletter de The Conversation pour mieux comprendre les grands enjeux du monde. Abonnez-vous aujourd’hui]

Bien que les attaques par rançongiciel les plus médiatisées concernent des organisations, des hôpitaux par exemple, les particuliers sont également touchés.

Dans le cas de l’usurpation d’identité, une personne malveillante utilise des informations personnelles qui permettent de nous identifier (« se logger ») sans notre accord : par exemple, en créant un faux profil sur une plate-forme et en rédigeant des commentaires sous l’identité de la victime afin de nuire à sa réputation.

À un autre niveau, la surveillance de masse exercée par certains États capture les informations personnelles de leurs citoyens afin d’entraver la liberté d’expression ou de ficher les individus par exemple. Une surveillance accrue peut tendre vers un sentiment d’absence de sphère privée et ainsi brider le comportement des individus.

En Europe, le RGPD (règlement général sur la protection des données) limite la récolte des données personnelles, notamment par les gouvernements, qui doivent justifier d’une raison suffisante pour toute surveillance.

Chacun d’entre nous a une empreinte numérique unique

Ces problèmes touchent chacun d’entre nous. En effet, dans un monde de plus en plus numérique où nous générons quotidiennement des données à travers notre navigation sur Internet, nos smartphones, ou nos montres connectées, nous avons tous une « empreinte numérique unique ».

En clair, il est généralement possible de réidentifier quelqu’un juste à partir des « traces » que nous laissons derrière nous sur nos appareils numériques.

une empreinte digitale à la craie
Nos données personnelles permettent de nous identifier, comme une empreinte digitale numérique. Immo Wegmann/Unsplash, CC BY

Par exemple, l’observation aléatoire de quatre lieux visités seulement représente une signature unique pour 98 % des individus. Cette unicité est généralisable dans un grand nombre de comportements humains.

Cacher l’identité du propriétaire de données personnelles uniquement derrière un pseudonyme n’est pas une protection suffisante face au risque de réidentification, il est nécessaire d’anonymiser les données.

Données synthétiques, apprentissage fédéré : les nouvelles méthodes pour protéger les données personnelles

Tels les membres d’un « black bloc » essayant d’être indistinguables entre eux en s’habillant de manière identique dans une manifestation houleuse, l’anonymisation de données a pour but d’éviter qu’une personne ne se démarque du reste de la population considérée, afin de limiter l’information qu’un cyberattaquant pourrait extraire.

Dans le cas de données de géolocalisation, on pourrait par exemple modifier les données afin que plusieurs utilisateurs partagent les mêmes lieux visités, ou alors introduire du bruit pour ajouter une incertitude sur les lieux réellement visités.

Mais cette anonymisation a un coût car elle « déforme » les données et diminue leur valeur : une trop grande modification des données brutes dénature l’information véhiculée dans les données anonymisées. De plus, pour s’assurer de l’absence d’une empreinte réidentifiante, les modifications nécessaires sont très importantes et souvent incompatibles avec nombre d’applications.

Trouver le bon compromis entre protection et utilité des informations anonymisées reste un challenge. À l’heure où certains voient les données comme le nouveau pétrole du XXIe siècle, l’enjeu est de taille car une donnée anonyme n’est plus considérée comme une donnée personnelle et échappe au RGPD, ce qui veut dire qu’elle peut être partagée sans consentement du propriétaire.

Cette difficulté de trouver un compromis acceptable entre protection et utilité des données au travers de mécanismes d’anonymisation a fait évoluer les pratiques. De nouveaux paradigmes de protection des données personnelles ont vu le jour.

Une première tendance consiste à générer des données synthétiques reproduisant les mêmes propriétés statistiques que les vraies données.

Ces données générées de manière artificielle ne sont par conséquent pas liées à une personne et ne seraient plus encadrées par le RGPD. Un grand nombre d’entreprises voient en cette solution des promesses de partage d’information moins limitées. En pratique, les risques résiduels des modèles de génération synthétique ne sont pas négligeables et sont encore à l’étude.

Une autre solution limitant le risque de partage de données personnelles est l’apprentissage fédéré. Dans l’apprentissage machine conventionnel, les données sont centralisées par une entité pour entraîner un modèle.

Dans l’apprentissage fédéré, chaque utilisateur se voit attribuer un modèle qu’il entraîne localement sur ses propres données. Il envoie ensuite le résultat à une entité qui s’occupe d’agréger l’ensemble des modèles locaux. De manière itérative, cet apprentissage décentralisé permet de créer un modèle d’apprentissage sans divulguer de données personnelles.

Ce nouveau paradigme de protection des données personnelles suscite beaucoup d’engouement. Cependant, plusieurs limitations subsistent, notamment sur la robustesse face aux acteurs malveillants qui souhaiteraient influencer le processus d’entraînement. Un participant pourrait par exemple modifier ses propres données pour que le modèle se trompe lors d’une tâche de classification particulière.The Conversation

Antoine Boutet, Maitre de conférence, Privacy, IA, au laboratoire CITI, Inria, INSA Lyon – Université de Lyon

Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.